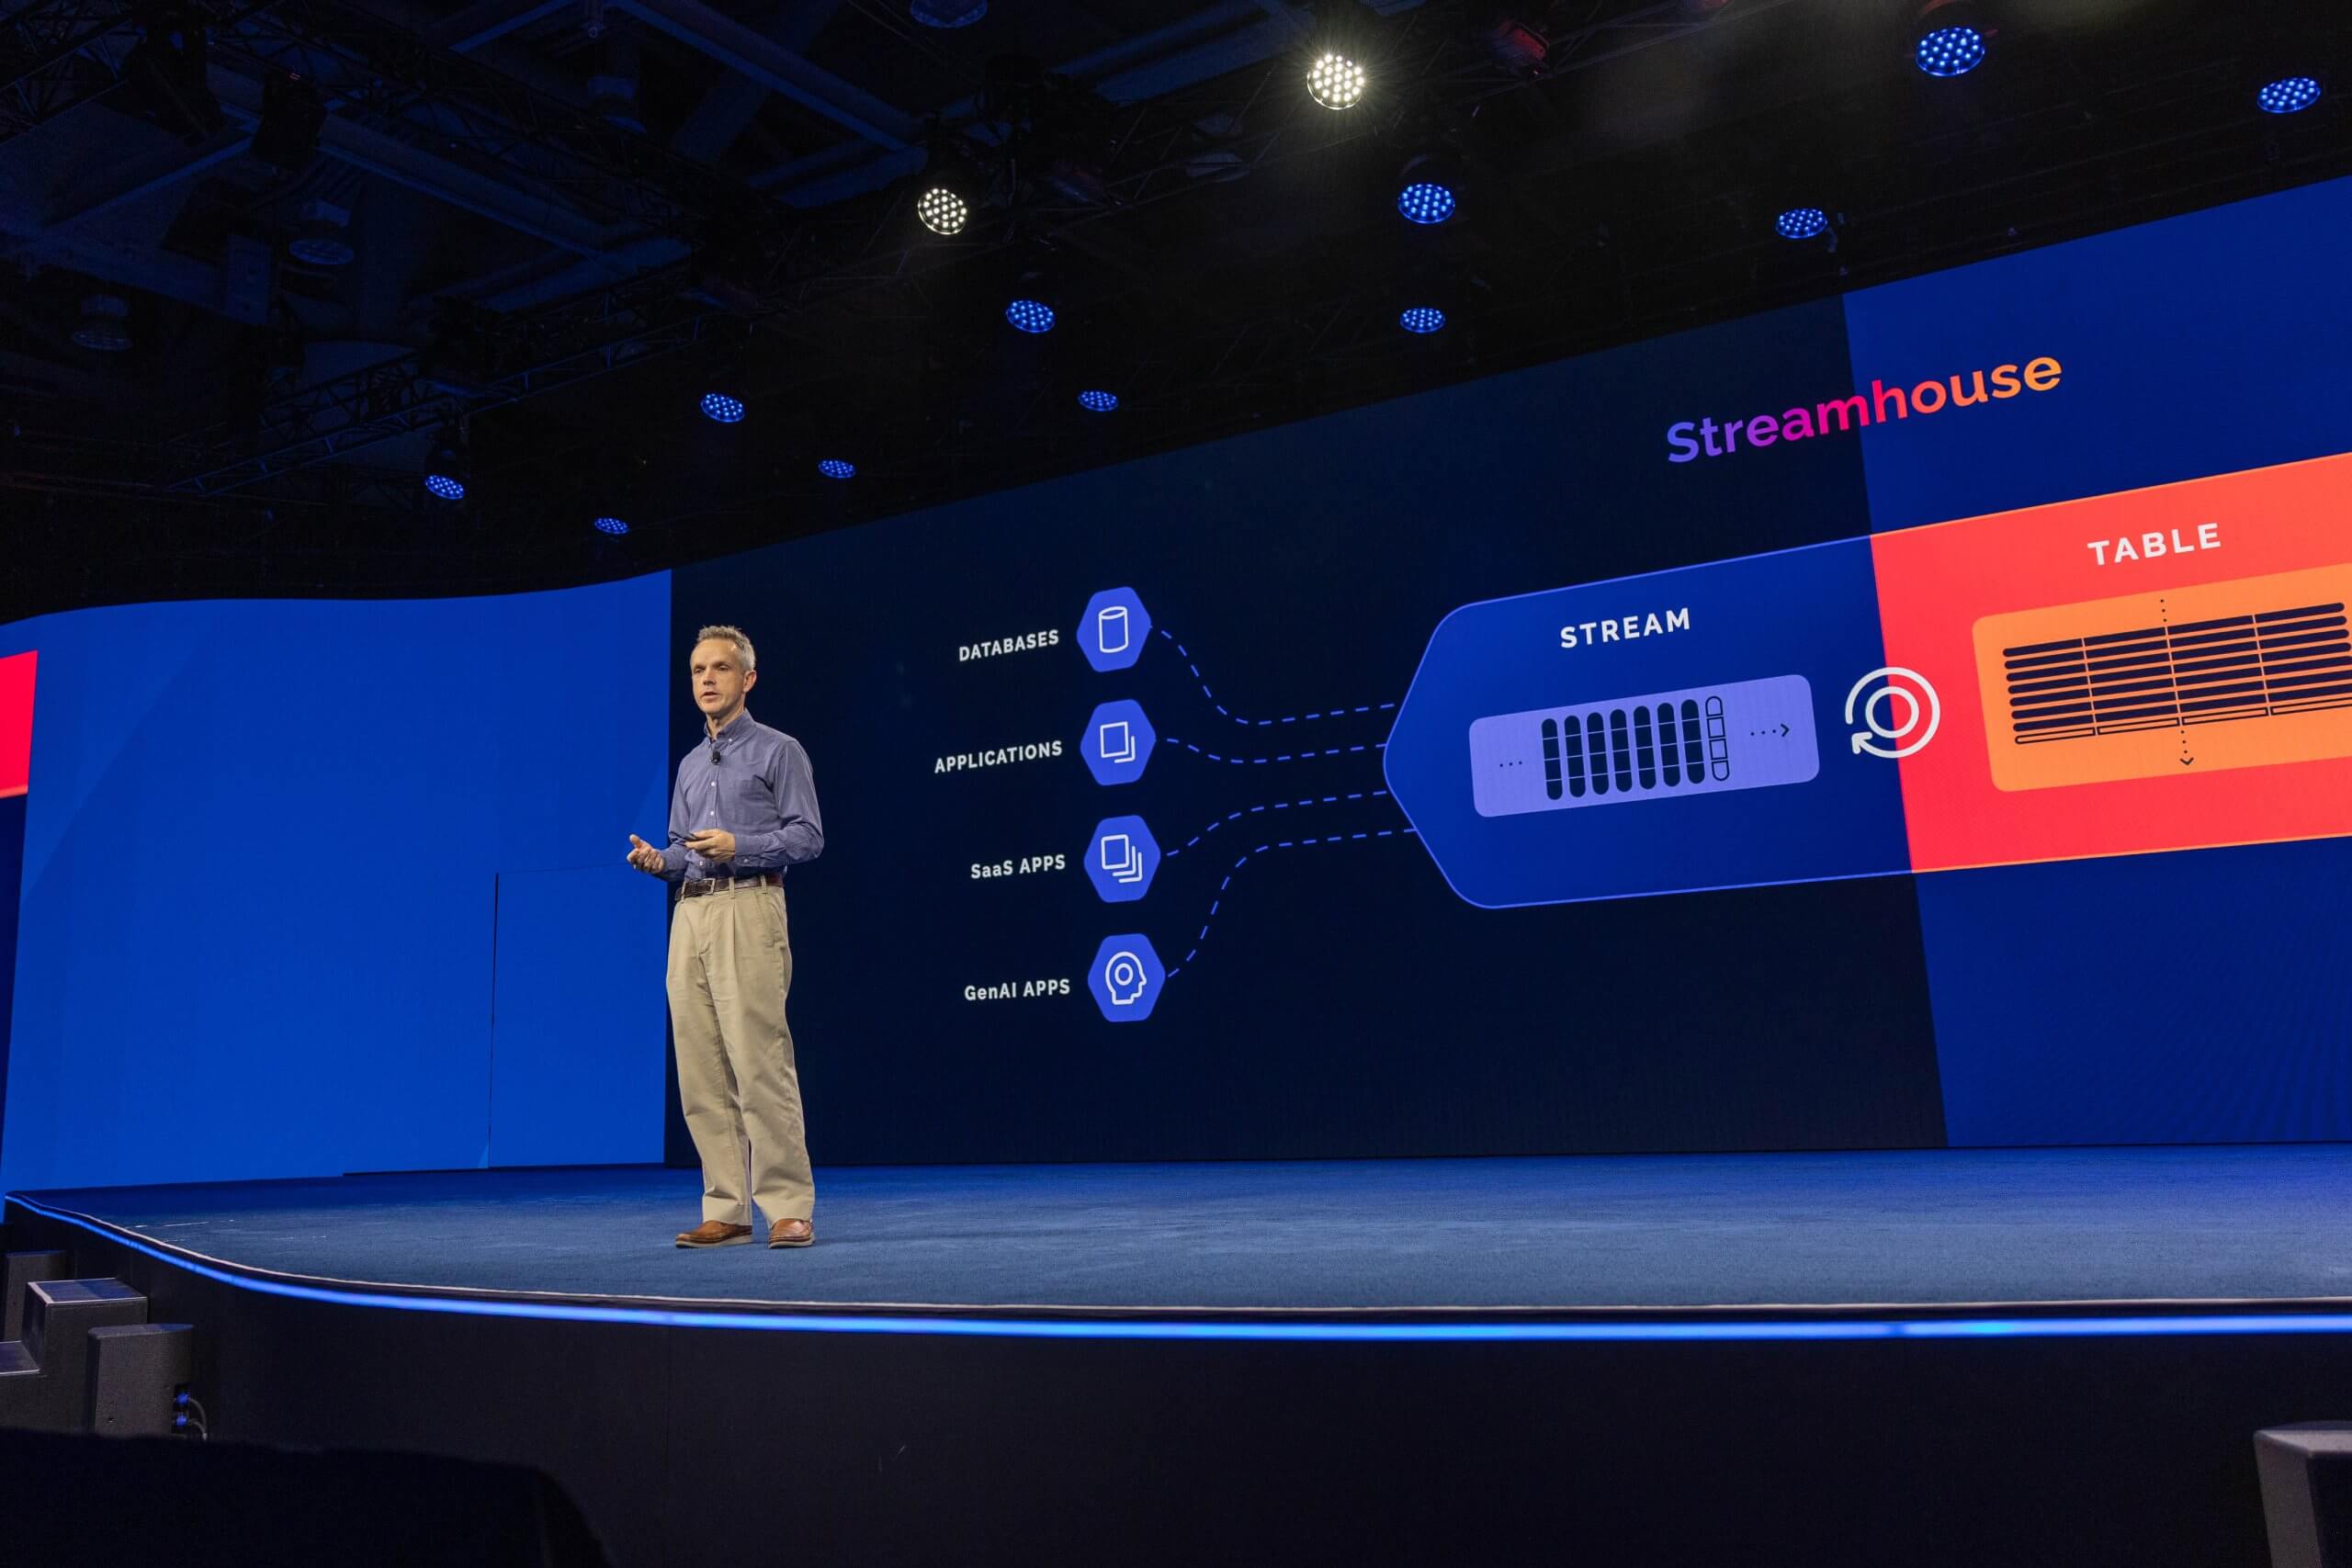
Confluent บริษัทในเครือ IBM ประกาศเปิดตัวความสามารถใหม่สำหรับการพัฒนา Streamhouse ซึ่งเป็นสถาปัตยกรรมข้อมูลรูปแบบใหม่ที่ช่วยทำให้ข้อมูลทางธุรกิจเป็นปัจจุบันอยู่เสมอ เพื่อนำมาใช้ร่วมกับ AI Agents แอปพลิเคชัน และระบบวิเคราะห์ข้อมูลในระหว่างที่ระบบกำลังตัดสินใจและดำเนินการต่าง ๆ โดยการเปิดให้บริการ Lightning Tables อย่างเป็นทางการบน AWS ในครั้งนี้ จะช่วยเติมเต็มขีดความสามารถทั้ง 5 เสาหลักของ Confluent Data Streaming Platform ได้แก่ Stream, Connect, Process, Govern และ Query ให้ทำงานร่วมกันบนแพลตฟอร์มเดียว สำหรับการพัฒนา Streamhouse ทั้งนี้ Confluent ถือเป็นองค์ประกอบสำคัญในกลยุทธ์ด้านข้อมูลของ IBM โดยผสานความสามารถในการสตรีมข้อมูลแบบเรียลไทม์เข้ากับเทคโนโลยีด้านการบูรณาการข้อมูล (Integration) การกำกับดูแลข้อมูล (Governance) และ AI ของ IBM เพื่อรองรับการทำงานในสภาพแวดล้อมแบบ Hybrid
ทำไมองค์กรจึงต้องมี Streamhouse
ทั้ง Data Lake, Data Warehouse และ Lakehouse ต่างถูกพัฒนาขึ้นโดยมีวัตถุประสงค์หลักเพื่อรองรับการจัดทำรายงานและการประมวลผลข้อมูลแบบเป็นรอบหรือ Batch Processing อย่างไรก็ตาม เมื่อ AI Agent เข้ามามีบทบาทในการทำงานขององค์กรมากขึ้น ระบบจำเป็นต้องตัดสินใจโดยอาศัยข้อมูลที่กระจายอยู่ตามระบบต่าง ๆ ซึ่งมีการอัปเดตในช่วงเวลาที่แตกต่างกัน และเมื่อแต่ละระบบแสดงสถานะปัจจุบันของธุรกิจไม่ตรงกัน AI Agent ก็อาจลงมือทำงานบนข้อมูลที่ล้าสมัยหรือขัดแย้งกัน ซึ่งส่งผลกระทบต่อเนื่องไปยังกระบวนการทำงานอื่น ๆ ภายในองค์กร
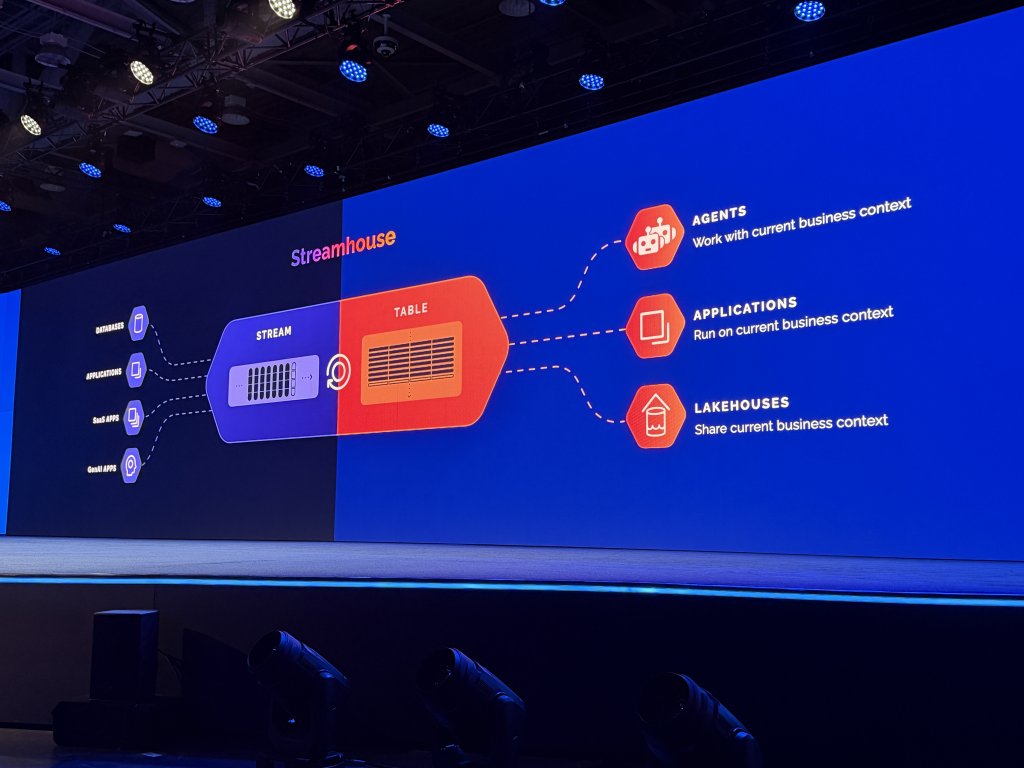
Streamhouse จึงเข้ามาแก้ไขข้อจำกัดด้านสถาปัตยกรรมข้อมูลดังกล่าว ด้วยการรวบรวม ประมวลผล กำกับดูแล และนำเสนอบริบทธุรกิจที่เป็นปัจจุบันอย่างต่อเนื่อง เพื่อให้ AI Agents แอปพลิเคชัน และระบบวิเคราะห์ข้อมูลสามารถเข้าถึงข้อมูลชุดเดียวกันได้ ยกตัวอย่างเช่น กรณีที่สายการบินต้องรับมือในการจัดการเที่ยวบินที่ถูกยกเลิก ดังนี้:
- ปัญหาในปัจจุบัน: ระบบต่าง ๆ อาจมีข้อมูลเกี่ยวกับการดำเนินงานเดียวกันที่ไม่ตรงกัน เช่น ระบบปฏิบัติการบินที่ติดตามตำแหน่งของเครื่องบิน ระบบจัดตารางเที่ยวบินที่ติดตามเวลาออกเดินทาง และระบบสำรองที่นั่งที่ติดตามที่นั่งว่าง เมื่อแต่ละระบบอัปเดตข้อมูลไม่พร้อมกัน AI Agents ที่ทำหน้าที่จัดการจองเที่ยวบินใหม่โดยอัตโนมัติ อาจจัดแผนการเดินทางที่ดูถูกต้องในแต่ละระบบ แต่ไม่สามารถใช้งานได้จริง เช่น ที่นั่งว่าง แต่เครื่องบินมาต่อเครื่องไม่ทัน ส่งผลให้ทีมบริการลูกค้าและระบบแจ้งเตือนทำงานบนข้อมูลที่คลาดเคลื่อน จนปัญหาขยายวงกว้าง
- การแก้ปัญหาด้วย Streamhouse: ทุกการเปลี่ยนแปลงของข้อมูลจะถูกสะท้อนไปยังภาพรวมการดำเนินงานร่วมกันทันที ไม่ว่าจะเป็นการเปลี่ยนแปลงตำแหน่งเครื่องบิน เที่ยวบินล่าช้า หรือมีการจองที่นั่ง ระบบต้นทางจะส่งข้อมูลการเปลี่ยนแปลงเข้าสู่กระแสข้อมูลอย่างต่อเนื่อง โดย Streamhouse จะรวบรวมข้อมูลเหล่านี้เพื่อสร้างบริบทธุรกิจที่เป็นปัจจุบัน และเปิดให้ AI Agent จองเที่ยวบินใหม่ ทีมบริการลูกค้า และแอปพลิเคชันต่าง ๆ เข้าถึงข้อมูลร่วมกันขณะปฏิบัติงาน แทนที่จะต้องรวบรวมข้อมูลจากหลายระบบที่มีการอัปเดตในช่วงเวลาที่ต่างกัน ซึ่งช่วยให้ทุกฝ่ายสามารถตรวจสอบตำแหน่งเครื่องบิน เวลาออกเดินทาง และสถานะที่นั่งว่างร่วมกันได้ทันที ก่อนเสนอแผนการเดินทางใหม่ให้แก่ผู้โดยสาร
ปัจจุบันองค์กรชั้นนำต่าง ๆ ได้เริ่มเห็นผลลัพธ์จากการนำสถาปัตยกรรม Streamhouse มาใช้งานแล้ว โดย Accenture ได้นำสถาปัตยกรรม Streamhouse ที่ขับเคลื่อนด้วย Confluent มาใช้เชื่อมโยงข้อมูลทั่วทั้งองค์กรระดับโลก
“Accenture ดำเนินธุรกิจครอบคลุมกว่า 120 ประเทศ ทำให้องค์กรระดับโลกของเราต้องเผชิญข้อจำกัดจากสถาปัตยกรรมแบบเดิมที่อาศัยการประมวลผลข้อมูลเป็นรอบและการเชื่อมต่อระบบแบบจุดต่อจุด ซึ่งส่งผลให้เกิดการดึงข้อมูลซ้ำซ้อน เพิ่มภาระในการดำเนินงาน และทำให้ข้อมูลสำหรับการวิเคราะห์ล่าช้ากว่าความเป็นจริง การเปลี่ยนมาใช้สถาปัตยกรรม Streamhouse ที่ขับเคลื่อนด้วย Confluent ช่วยแยกการทำงานระหว่างระบบผู้ผลิตข้อมูลและระบบผู้ใช้ข้อมูลออกจากกัน พร้อมเปลี่ยนกระแสข้อมูลปริมาณมหาศาลให้เป็น Data Products แบบเรียลไทม์ที่ผ่านการกำกับดูแล และสามารถนำกลับมาใช้ซ้ำได้ รวมถึงเชื่อมโยงระหว่างระบบปฏิบัติการและระบบวิเคราะห์ข้อมูลได้อย่างราบรื่น
Confluent ช่วยจัดการระบบโครงสร้างพื้นฐานโดยอัตโนมัติ พร้อมรองรับการเชื่อมต่อระดับองค์กรอย่างไร้รอยต่อ ทำให้นักพัฒนาสามารถทำงานบนสภาพแวดล้อมมาตรฐานเดียวกัน โดยไม่ต้องเสียเวลาและทรัพยากรไปกับการสร้างระบบเชื่อมต่อเฉพาะทาง หรือคอยบริหารจัดการการเคลื่อนย้ายข้อมูลด้วยตนเอง รากฐานข้อมูลที่ทำงานอย่างต่อเนื่องนี้ ช่วยลดระยะเวลาตั้งแต่การรวบรวมข้อมูลไปจนถึงการได้รับข้อมูลเชิงลึก (Time-to-Insight) จากเดิมที่ใช้เวลาหลายเดือนเหลือเพียงไม่กี่วัน พร้อมลดระยะเวลาในการจัดทำรายงานอย่างมีนัยสำคัญ ทำให้บุคลากรของเรากว่า 800,000 คนสามารถมุ่งเน้นไปที่การพัฒนา AI ที่สร้างมูลค่าเพิ่มให้กับองค์กรได้มากขึ้น” Thomas Mahaffey, SAI Chief Data Strategist, Accenture กล่าว
จุดเด่นที่ทำให้ Streamhouse แตกต่าง
Streamhouse พัฒนาขึ้นบนหลักการสำคัญ 3 ประการ ได้แก่ ความเป็นปัจจุบันของข้อมูล (Current) ความสำคัญต่อภารกิจหลักของธุรกิจ (Mission-Critical) และการกระจายศูนย์ (Decentralized) โดยช่วยรักษาบริบทธุรกิจให้ได้รับการอัปเดตอย่างต่อเนื่อง ออกแบบมาเพื่อรองรับมาตรฐานการให้บริการในระดับ Production และสามารถเข้าถึงข้อมูลจากแหล่งจัดเก็บเดิมได้โดยไม่จำเป็นต้องรวบรวมข้อมูลทั้งหมดมาไว้ในที่เดียวก่อน นอกจากนี้ Streamhouse ยังสามารถทำงานร่วมกับ Data Warehouses และ Lakehouses ที่องค์กรใช้งานอยู่แล้ว โดยเพิ่มชั้นการประมวลผลข้อมูลเชิงปฏิบัติการแบบเรียลไทม์เพื่อรองรับการตัดสินใจและการดำเนินงานต่าง ๆ
“Extend ในฐานะแพลตฟอร์มด้านการค้าปลีกที่พัฒนาขึ้นโดยมี AI เป็นหัวใจสำคัญ ซึ่งมุ่งมอบประสบการณ์การเลือกซื้อสินค้าแบบเฉพาะบุคคล พร้อมสร้างความได้เปรียบด้านการดำเนินงานและการเงินให้แก่ผู้ค้า Extend จำเป็นต้องมีความยืดหยุ่นสูงในการรองรับการเริ่มต้นใช้งานของร้านค้าอย่างรวดเร็ว การปรับราคาแบบเรียลไทม์ รวมถึงการตรวจจับการฉ้อโกงได้ทันที ในช่วงแรก Extend ประสบปัญหาจากการใช้ Message Queue แบบดั้งเดิมและ Data Lake ที่จัดเก็บข้อมูลแบบคงที่ ซึ่งขาดความสามารถในการเรียกดูและประมวลผลข้อมูลเหตุการณ์ซ้ำ การจัดเก็บข้อมูลอย่างต่อเนื่อง และการบังคับใช้ Schema อย่างเข้มงวดเมื่อระบบขยายตัวในระดับที่ใหญ่ขึ้น การนำสถาปัตยกรรม Streamhouse แบบ Serverless 100% ที่ใช้ Confluent Cloud เป็นรากฐานมาใช้งาน ช่วยให้ Kafka กลายเป็นแหล่งข้อมูลหลักสำหรับการดำเนินงาน ทำให้ Microservices ในระบบปลายทางสามารถเรียกใช้และ Query ข้อมูลเรียลไทม์ได้แบบไม่พร้อมกัน โดยที่ไม่กระทบต่อข้อตกลงหรือโครงสร้างข้อมูลระหว่างระบบ รากฐานการสตรีมข้อมูลที่แยกการทำงานออกจากกันอย่างเป็นอิสระนี้ ช่วยเพิ่มความยืดหยุ่นและความสามารถในการตอบสนองที่จำเป็นต่อการขยายธุรกิจ การปรับตัวตามทิศทางตลาดแบบเรียลไทม์ และการขับเคลื่อนกระบวนการทำงานของ Agentic AI” Jonathan Kropp, Director of AI and Architecture, Extend กล่าว
Confluent Data Streaming Platform ยกระดับสู่แพลตฟอร์ม Streamhouse อย่างครบวงจร
Confluent Data Streaming Platform มอบรากฐานแบบครบวงจรและเป็นหนึ่งเดียวสำหรับการพัฒนา Streamhouse โดยมี Apache Kafka® เป็นเทคโนโลยีหลักในการรวบรวมและสตรีมข้อมูลเหตุการณ์ทางธุรกิจ อย่างไรก็ตาม การใช้ Kafka เพียงอย่างเดียวยังทำให้องค์กรต้องคอยพัฒนาขีดความสามารถอื่น ๆ เพิ่มเติมด้วยตนเอง เพื่อเปลี่ยนข้อมูลเหตุการณ์เหล่านั้นให้กลายเป็นบริบทธุรกิจที่เป็นปัจจุบัน Confluent Data Streaming Platform จึงรวบรวมความสามารถทั้งหมดไว้บนแพลตฟอร์มเดียว พร้อมเพิ่ม Query เข้ามาเป็นองค์ประกอบหลักด้านที่ 5 ร่วมกับ Stream, Connect, Process และ Govern โดยแต่ละองค์ประกอบมีความสามารถสำคัญและการพัฒนาใหม่ ๆ ดังนี้
- Stream: ขับเคลื่อนด้วย Apache Kafka และ Kora Engine มอบโครงสร้างพื้นฐานที่มีความเสถียรและรองรับการขยายระบบ เพื่อรวบรวมและสตรีมข้อมูลเหตุการณ์ทางธุรกิจระหว่างระบบต่าง ๆ โดยจากการทดสอบภายในของ Confluent พบว่ามีความหน่วงต่ำกว่าหนึ่งมิลลิวินาที ทั้งนี้ ความหน่วงในการใช้งานจริงอาจแตกต่างกันไปตามการกำหนดค่าและลักษณะของ Workload ที่ตั้งไว้
- Connect: ด้วย Managed และ Custom Connectors มากกว่า 150 รายการ ช่วยนำข้อมูลจากระบบองค์กรเข้าสู่ Kafka และส่งต่อไปยังระบบปลายทาง โดยการบริหารจัดการ Hybrid Connectors จะช่วยขยายขีดความสามารถให้ทีมงานจัดการการเชื่อมต่อเหล่านั้นได้ดียิ่งขึ้น
- Process: ใช้ Apache Flink เพื่อรวบรวม ผสาน และเพิ่มบริบทให้กับข้อมูลทางธุรกิจใกล้แหล่งกำเนิดข้อมูล แบบเรียลไทม์ พร้อมเพิ่มความสามารถในการประมวลผลแบบเป็นรอบ เพื่อช่วยเริ่มต้น Workloads สำหรับการสตรีมข้อมูลจากข้อมูลที่มีอยู่เดิม
- Govern: ช่วยให้องค์กรสามารถค้นหา จัดประเภท และรักษาความปลอดภัยของข้อมูล ผ่านความสามารถด้าน Data Lineage, Data Catalog, Data Quality, Encryption, Schema และ Access Control
- Query: ช่วยนำเสนอบริบทธุรกิจที่เป็นปัจจุบันให้แก่ระบบวิเคราะห์ข้อมูล AI Agents และแอปพลิเคชันต่าง ๆ
Query ช่วยให้ Data Streaming สามารถนำไปใช้ประโยชน์กับระบบวิเคราะห์ข้อมูล AI Agents และแอปพลิเคชันได้ โดยรองรับการเข้าถึงผ่านอินเทอร์เฟซที่เหมาะสมกับแต่ละรูปแบบการใช้งาน ได้แก่
- Confluent Tableflow ช่วยนำข้อมูลสตรีมมิงไปใช้งานบน Lakehouses และ Data Warehouses ในรูปแบบ Open Table Format เพื่อรองรับการวิเคราะห์ข้อมูล
- Real-Time Context Engine ช่วยนำเสนอบริบทธุรกิจที่เป็นปัจจุบันให้แก่ AI Agents ผ่าน Model Context Protocol (MCP)
- Lightning Tables ช่วยให้แอปพลิเคชันสามารถเข้าถึงสถานะปัจจุบันของธุรกิจผ่าน SQL และ API ด้วยความหน่วงต่ำ เพื่อตอบสนองต่อการเปลี่ยนแปลงของข้อมูลได้อย่างรวดเร็ว
Lightning Tables: เข้าถึงสถานะปัจจุบันของธุรกิจได้อย่างรวดเร็ว
Lightning Tables เปิดให้บริการอย่างเป็นทางการบน AWS ผ่าน Confluent Cloud โดยทำหน้าที่เป็นชั้นการให้บริการข้อมูลแบบอ่านอย่างเดียว (Read-Only Serving Layer) ที่จัดเก็บและแปลงข้อมูลจาก Apache Kafka ให้อยู่ในรูปแบบตาราง พร้อมอัปเดตข้อมูลให้เป็นปัจจุบันอย่างต่อเนื่องเมื่อเกิดการเปลี่ยนแปลง ช่วยให้ผู้ใช้งานสามารถ Query ข้อมูลสถานะปัจจุบันของธุรกิจได้ด้วยความหน่วงต่ำ โดยความสามารถสำคัญของ Lightning Tables ได้แก่
- ความสดใหม่ของข้อมูลและประสิทธิภาพในการ Query: จากการทดสอบภายในของ Confluent พบว่าสามารถนำข้อมูลใหม่มาให้บริการได้ภายในเวลาประมาณ 100 มิลลิวินาที นับจากเวลาที่ข้อมูลถูกสร้างขึ้น โดยมี Query Latency อยู่ที่ 10–100 มิลลิวินาที และรองรับปริมาณการ Query มากกว่า 1,000 ครั้งต่อวินาที
- ลดต้นทุนและความซับซ้อน: รองรับการให้บริการข้อมูลอย่างต่อเนื่องผ่าน Serving Layer ที่บริหารจัดการแบบเต็มรูปแบบ โดยไม่จำเป็นต้องสร้าง ETL Pipeline ฐานข้อมูล หรือระบบ Cache แยกต่างหาก
- รองรับการ Query ผ่านหลากหลายช่องทาง: สามารถเข้าถึงข้อมูลผ่าน SQL และ Direct API
- การกำกับดูแลข้อมูลแบบรวมศูนย์: สามารถนำ Schema, Data Lineage และนโยบายการควบคุมสิทธิ์การเข้าถึงข้อมูล ได้ตั้งแต่ขั้นตอนการรวบรวมข้อมูล ไปจนถึงการนำข้อมูลไปให้บริการ
- การปรับเปลี่ยน Schema: รองรับการบริหารจัดการการเปลี่ยนแปลง Schema เพื่อช่วยป้องกันไม่ให้แอปพลิเคชันในระบบปลายทางเกิดปัญหาจากการเปลี่ยนแปลงโครงสร้างข้อมูล
- Feature Store: สามารถประมวลผลฟีเจอร์ ผ่าน Flink และจัดเก็บข้อมูลเพื่อรองรับการใช้งานด้าน Machine Learning รวมถึงการนำเสนอประสบการณ์เฉพาะบุคคลแบบเรียลไทม์
“องค์กรต่าง ๆ ทั่วทั้งภูมิภาคเอเชียแปซิฟิก กำลังขยายระบบบริการดิจิทัลอย่างก้าวกระโดด แต่ในขณะเดียวกัน ลูกค้าและระบบการดำเนินงานกลับคาดหวังประสบการณ์ที่สามารถตอบสนองได้แบบทันที ซึ่งสิ่งนี้สร้างโจทย์ใหญ่ในเชิงปฏิบัติสำหรับ AI เพราะ AI Agents จะสามารถตัดสินใจได้อย่างมีประสิทธิภาพก็ต่อเมื่อระบบมองเห็นสถานะที่เป็นจริงทั่วทั้งองค์กร ณ เวลาที่ลงมือปฏิบัติการเท่านั้น Streamhouse จึงเข้ามามอบรากฐานข้อมูลที่ได้รับการอัปเดตอย่างต่อเนื่องและผ่านการกำกับดูแล เพื่อให้แอปพลิเคชันและ AI Agents สามารถทำงานบนภาพรวมข้อมูลที่เป็นปัจจุบันชุดเดียวกันได้ สิ่งนี้จะช่วยให้องค์กรสามารถต่อยอดจากระบบข้อมูลเดิมที่มีอยู่ เพื่อขยายผลการนำ AI ที่ตอบสนองได้รวดเร็วและสอดรับกับสภาวะจริงมาประยุกต์ใช้ในกระบวนการทำงานได้อย่างแท้จริง” Greg Taylor, SVP & General Manager, APAC Confluent กล่าว